Vom Finding zum Fix: Wann ist ein Pentest-Befund wirklich behoben?
Ein angemeldeter Kunde ändert die Rechnungs-ID in der Download-URL und erhält das PDF eines anderen Mandanten. Die Lücke ist in wenigen Minuten reproduziert. Das Entwicklungsteam ergänzt im Controller eine Berechtigungsprüfung; der Request aus dem Pentest-Bericht scheitert. Das Ticket ist zu.
Vier Wochen später lässt sich dieselbe Rechnung weiterhin abrufen – über einen Exportendpunkt.
Das Beispiel ist konstruiert, der Fehler dahinter aber realistisch: Der Patch schützt einen Endpunkt. Die Anwendung setzt Objektberechtigungen jedoch weiterhin uneinheitlich durch. Der Pentest-Bericht zeigt zunächst nur den nachgewiesenen Angriffsweg. Für die Behebung muss das Team herausfinden, wo die Autorisierungsentscheidung falsch oder gar nicht getroffen wird.
Ein geschlossenes Ticket kann vier verschiedene Dinge bedeuten
In der Praxis werden mehrere Zustände schnell unter dem Wort „behoben“ zusammengefasst:
- Der konkrete Proof of Concept funktioniert nicht mehr.
- Die Schwachstelle wurde am dokumentierten Endpunkt geschlossen.
- Die zugrunde liegende Fehlerklasse wurde auch an verwandten Stellen adressiert.
- Die Korrektur ist in der vorgesehenen Zielumgebung ausgerollt und dort verifiziert.
Diese Zustände sind nicht gleichwertig. Ein zusätzlicher Filter kann genau den im Bericht verwendeten Wert abfangen. Eine lokale Prüfung kann den betroffenen REST-Endpunkt absichern. Beides sagt noch nichts über eine ältere API-Version, einen GraphQL-Resolver, einen PDF-Export oder einen Hintergrundjob aus.
Auch ein grüner Unit-Test belegt zunächst nur, dass der getestete Codepfad das erwartete Ergebnis liefert. Ob der richtige Build auf der Test- oder Produktivumgebung läuft und ob alternative Zugriffspfade weiterhin offen sind, ist eine andere Frage.
Praxisbeispiel: Die Rolle stimmt, das Objekt nicht
Nehmen wir ein B2B-Abrechnungsportal mit mehreren Mandanten. Ein Benutzer des Mandanten A darf Rechnungen lesen und besitzt deshalb die Berechtigung INVOICE_READ. Der Download erfolgt über eine API:
GET /api/invoices/8d87b86e-5e4e-4c98-b31a-d8e2e73062fa/pdf HTTP/1.1
Host: billing.example
Authorization: Bearer dXNlci1hLXRva2Vu
Die Anwendung prüft die Anmeldung und die Rolle. Anschließend lädt sie die Rechnung anhand der übergebenen UUID:
@PreAuthorize("hasAuthority('INVOICE_READ')")
public InvoicePdf download(UUID invoiceId) {
    Invoice invoice = invoiceRepository.findById(invoiceId)
        .orElseThrow(NotFoundException::new);

    return pdfService.render(invoice);
}
Der Code beantwortet eine Frage korrekt: Darf dieser Benutzer grundsätzlich Rechnungen lesen?
Eine zweite Frage fehlt: Darf er genau diese Rechnung lesen?
Kennt Benutzer A die UUID einer Rechnung des Mandanten B, wird auch dieses Objekt gefunden. Eine zufällige UUID erschwert zwar das blinde Durchzählen von Datensätzen. Sie stellt aber keine Berechtigungsprüfung dar. Identifikatoren tauchen beispielsweise in E-Mails, Exporten, Freigabelinks, Protokollen oder Antworten anderer Endpunkte auf. Auch OWASP weist bei Broken Object Level Authorization darauf hin, dass der Datentyp des Identifikators – fortlaufende Zahl, UUID oder Zeichenkette – das Grundproblem nicht löst.
Die API ist damit anfällig für Broken Object Level Authorization, kurz BOLA. Im Kontext klassischer Webanwendungen wird häufig der Begriff IDOR verwendet. Die Begriffe sind nicht in jeder Taxonomie vollständig deckungsgleich; praktisch beschreiben sie hier denselben Kernfehler: Ein kontrollierbarer Objektbezug führt zu einem Datensatz, ohne dass die Anwendung die Berechtigung für diesen Datensatz zuverlässig prüft.
Warum ein lokaler Patch zu kurz greifen kann
Die naheliegende Korrektur ergänzt im Download-Controller eine Prüfung der Mandantenzugehörigkeit der Rechnung. Der dokumentierte Request wird danach abgewiesen. Das ist besser als vorher, aber die Anwendung besitzt womöglich weitere Wege zum selben Objekt:
GET  /api/v1/invoices/{invoiceId}
GET  /api/reports/invoices/{invoiceId}.pdf

POST /graphql
{"query":"query { invoice(id: \"8d87b86e-5e4e-4c98-b31a-d8e2e73062fa\") { id } }"}

POST /api/invoices/export
{"invoiceIds":["8d87b86e-5e4e-4c98-b31a-d8e2e73062fa"]}
Vielleicht verwendet nur einer dieser Pfade den neuen Check. Vielleicht greift der Export auf einen gemeinsam genutzten Service zu, der weiterhin global mit findById() sucht. Oder das PDF liegt nach der ersten berechtigten Erzeugung in einem Cache, dessen Schlüssel nur aus der Rechnungs-ID besteht.
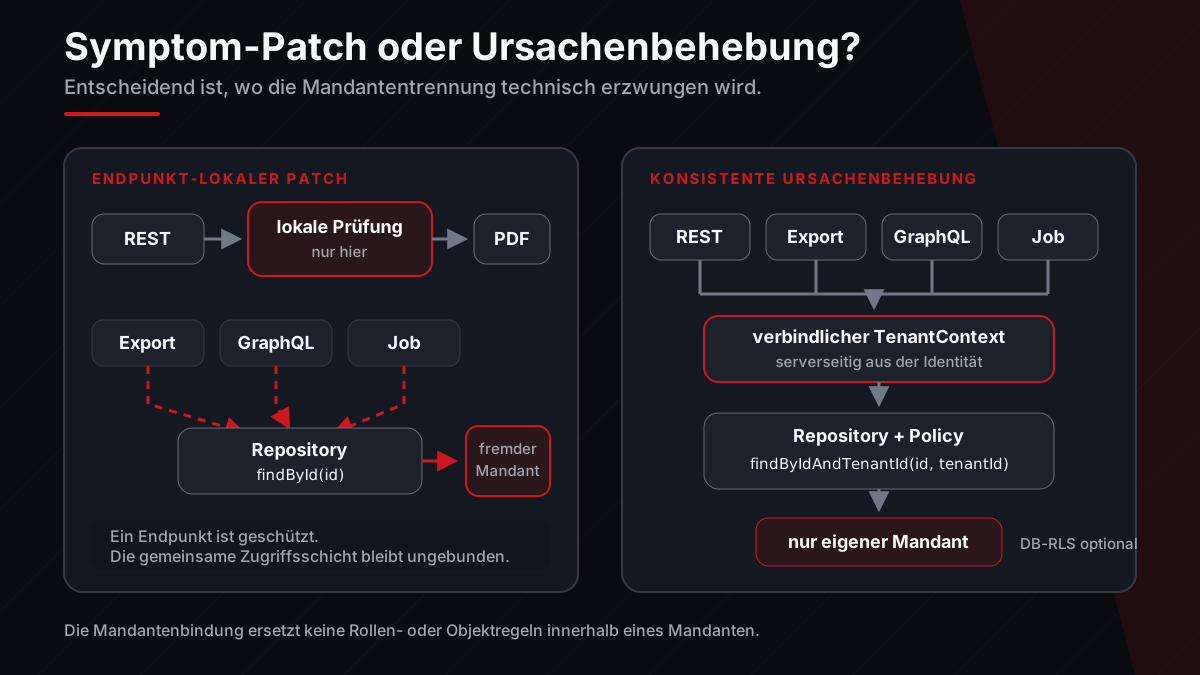
Mandantentrennung endet außerdem nicht am Controller oder an der relationalen Datenbank. Dieselbe Grenze muss in Caches, Suchindizes, Objektspeichern, Warteschlangen und Hintergrundprozessen gelten. Ein korrekt gefiltertes Repository nützt wenig, wenn ein asynchroner Exportjob den Mandantenkontext verliert oder ein globaler Cache ein bereits erzeugtes Dokument an den falschen Aufrufer ausliefert.
Nicht jeder Befund rechtfertigt deshalb einen Architekturumbau. Bei einer inkonsistenten Autorisierung gehört die Suche nach weiteren Verwendungen derselben Sicherheitsentscheidung aber zur Behebung.
Die Korrektur gehört an eine verlässliche Schicht
Eine robuste Lösung bindet den Datenzugriff an einen vertrauenswürdig ermittelten Sicherheitskontext. Vereinfacht könnte die Abfrage so aussehen:
@PreAuthorize("hasAuthority('INVOICE_READ')")
public InvoicePdf download(UUID invoiceId) {
    UUID tenantId = tenantContext.requireTenantId();

    Invoice invoice = invoiceRepository
        .findByIdAndTenantId(invoiceId, tenantId)
        .orElseThrow(NotFoundException::new);

    return pdfService.render(invoice);
}
Wichtig ist die Herkunft der tenantId. Sie darf nicht ungeprüft aus einem URL-Parameter, dem JSON-Body oder einem Header wie X-Tenant-ID übernommen werden. Unterstützt die Anwendung einen Mandantenwechsel, muss sie zusätzlich prüfen, ob der angemeldete Benutzer dem gewählten Mandanten angehört und welche Rechte er dort besitzt.
Auch @PreAuthorize ist nicht auf einfache Rollenprüfungen beschränkt. Spring Method Security kann eigene Autorisierungslogik einbinden und objektbezogene Entscheidungen treffen. Entscheidend ist daher nicht die Annotation selbst, sondern die Qualität und Konsistenz der hinterlegten Regel.
Je nach Architektur kommen weitere Schutzschichten hinzu:
- zentrale Policy- oder Autorisierungskomponenten,
- mandantengebundene Repository-Abfragen,
- getrennte Schlüsselräume für Cache, Objektspeicher und Warteschlangen,
- negative Integrationstests mit mindestens zwei Mandanten,
- bei geeigneten Datenmodellen eine zusätzliche Row-Level Security in der Datenbank.
Auch PostgreSQL Row-Level Security deckt nur den Datenbankzugriff ab. Dateien, Suchindizes und Caches bleiben davon unberührt; zudem müssen Datenbankrollen, Connection-Pooling und Mandantenkontext zusammenpassen.
Vom Befund zur verifizierten Behebung
Bei komplexeren Befunden hilft es, Reproduktion, Ursache, Korrektur und Deployment bewusst auseinanderzuhalten:
- Befund reproduzieren. Das Team sollte die Voraussetzungen, Identitäten, Requests und Auswirkungen nachvollziehen können. Unklarheiten werden besser vor der Implementierung mit dem Pentester geklärt.
- Ursache bestimmen. Liegt der Fehler im Controller, in einem gemeinsam genutzten Service, im Datenzugriff, im Rollenmodell oder im Verlust des Sicherheitskontexts zwischen Diensten?
- Verwandte Pfade suchen. Gleiche Ressourcen, wiederverwendete Methoden, ältere API-Versionen sowie Listen-, Export-, Historien-, Sammel- und Downloadfunktionen verdienen besondere Aufmerksamkeit.
- Auf der passenden Ebene korrigieren. Ein lokaler Check kann richtig sein. Bei systematisch wiederverwendeter Logik ist eine zentrale Regel häufig belastbarer.
- Negative Tests ergänzen. Neben dem erlaubten Zugriff werden ausdrücklich fremde Objekte, andere Mandanten, Rollenwechsel und unzulässige Aktionen geprüft.
- In die Zielumgebung ausrollen. Branch, Build-Artefakt und tatsächlich betriebene Version müssen zusammenpassen.
- Befund und Varianten erneut testen. Der ursprüngliche Angriffspfad wird wiederholt; naheliegende Umgehungen werden im vereinbarten Umfang einbezogen.
- Mit Nachweisen schließen. Ticket oder Risikoregister sollten festhalten, was geändert, wo es ausgerollt und was anschließend verifiziert wurde.
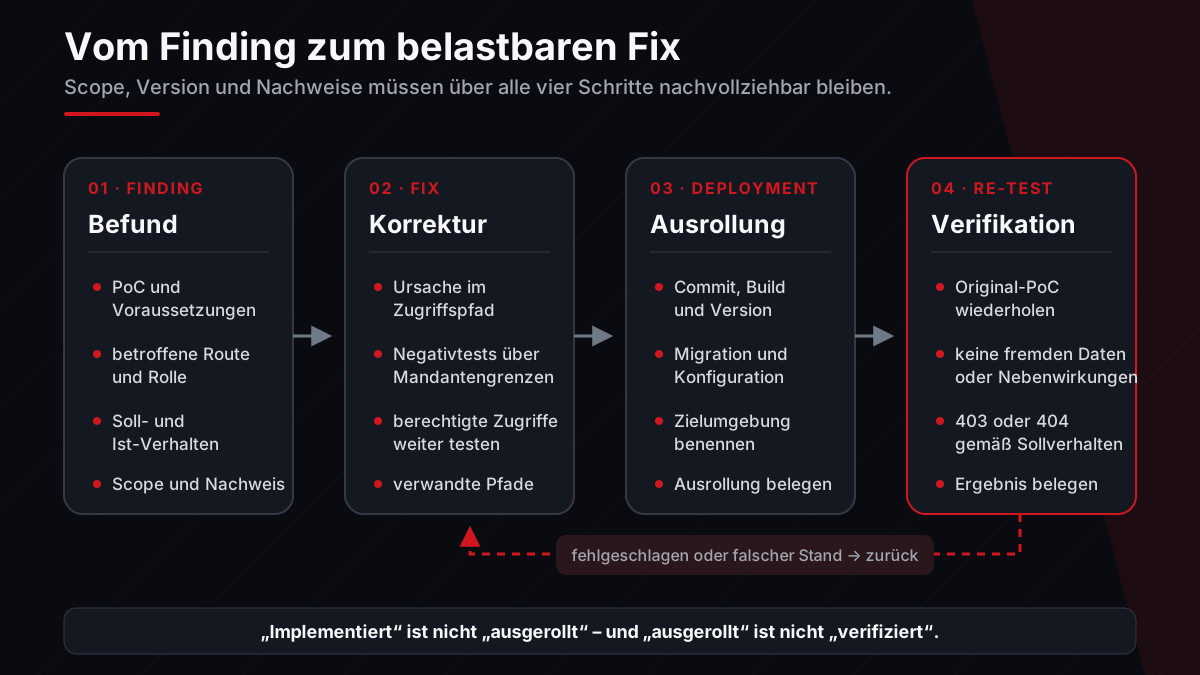
Bei einem fehlenden HTTP-Sicherheitsheader wäre dieser Ablauf überdimensioniert. Bei einer fehlerhaften Mandantentrennung ist er gerechtfertigt: Mehrere Rollen, Endpunkte und Speicherorte können betroffen sein.
Eine Testmatrix deckt Autorisierungslücken auf
Für Regressionstests reicht es nicht, nur einzelne Endpunkte mit einem Administratorkonto aufzurufen. Autorisierung beschreibt die Beziehung zwischen Identität, Rolle, Mandant, Objekt und Aktion. Eine kleine Testmatrix macht diese Beziehungen sichtbar:
| Identität | Ressource | Aktion | Erwartung |
|---|---|---|---|
| Benutzer A, Mandant A | Rechnung A | Lesen | erlaubt |
| Benutzer A, Mandant A | Rechnung B | Lesen | abgelehnt |
| Benutzer A, Mandant A | Rechnung B | Ändern | abgelehnt |
| Admin A, Mandant A | Rechnung B | Exportieren | abgelehnt |
| Support-Rolle | Rechnung B | Lesen | gemäß expliziter Support-Policy |
Aus dieser Matrix lassen sich Integrations- und Regressionstests ableiten. Für kritische Ressourcen sollten Lese-, Änderungs- und Löschzugriffe ebenso wie Download-, Export-, Such-, Historien- und Sammelfunktionen betrachtet werden. Das OWASP Authorization Regression Testing Cheat Sheet beschreibt genau diesen Ansatz: Berechtigungsregeln werden als überprüfbare Matrix modelliert und kontinuierlich gegen Regressionen getestet.
Solche Tests ersetzen keinen vollständigen Pentest. Sie sorgen aber dafür, dass eine einmal verstandene Regel nicht bei der nächsten Erweiterung unbemerkt verloren geht.
Die höchste CVSS-Zahl ist nicht automatisch zuerst dran
Ein CVSS-Wert hilft, die technische Schwere eines Befunds einheitlich zu beschreiben. Für die Reihenfolge der Behebung braucht das Team zusätzlichen Kontext. CVSS 4.0 sieht dafür neben den Basismetriken ausdrücklich Bedrohungs- und Umgebungsmetriken vor.
Bei der Priorisierung zählen unter anderem:
- Welche Daten und Geschäftsprozesse sind betroffen?
- Ist die Schwachstelle extern erreichbar und zuverlässig ausnutzbar?
- Betrifft sie einen Benutzer, einen Mandanten oder potenziell die gesamte Plattform?
- Existieren kompensierende Kontrollen?
- Kann der Befund mit anderen Schwachstellen kombiniert werden?
- Wie riskant ist die Änderung kurz vor einem Release?
Eine Cross-Tenant-Lücke in einem Rechnungsexport kann für das Unternehmen dringlicher sein als ein isoliert betrachteter technischer Score vermuten lässt. Umgekehrt kann ein hoch bewerteter Befund in einer abgeschotteten, stillgelegten Komponente in der Praxis weniger zeitkritisch sein. Die Entscheidung sollte dokumentiert sein – gerade dann, wenn ein Team bewusst von der Reihenfolge im Bericht abweicht.
Was ein Retest bestätigt – und was nicht
Ein Retest prüft in der bereitgestellten Version, ob die zuvor nachgewiesenen Schwachstellen nach der Korrektur noch reproduzierbar sind. Je nach Auftrag gehören naheliegende Varianten und mögliche Bypässe dazu. Er liefert damit eine unabhängige technische Aussage über den Status der Korrektur.
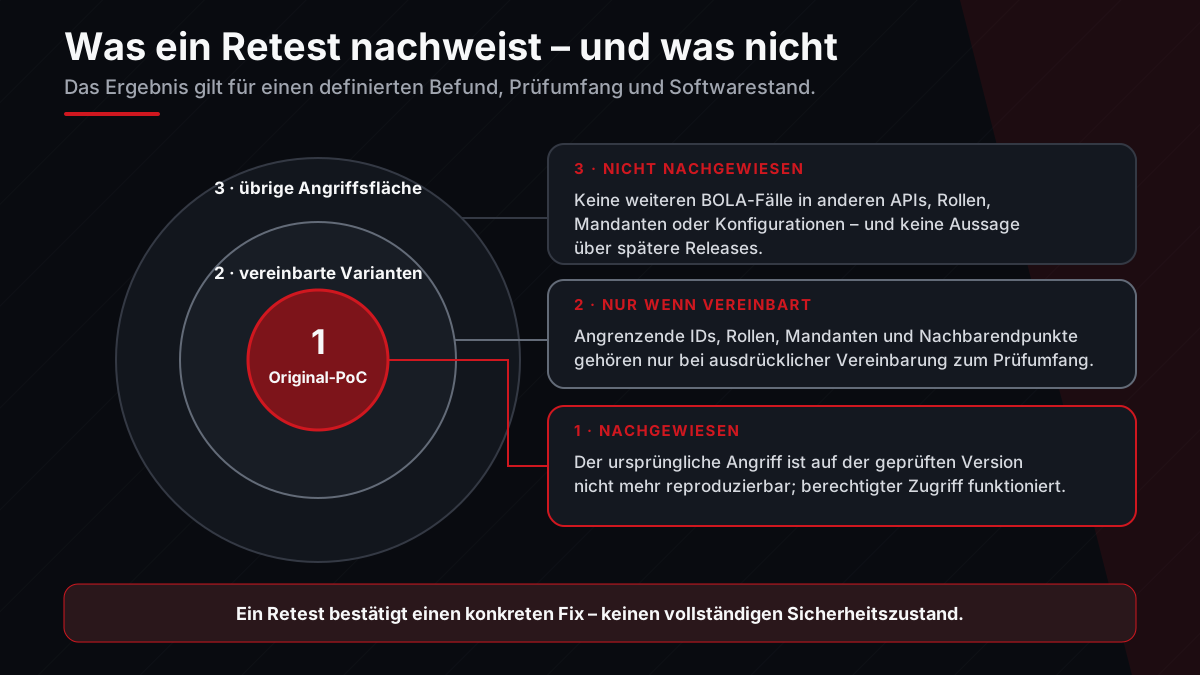
Ein Retest ist allerdings kein vollständiger neuer Pentest. Neue Funktionen, größere Architekturänderungen oder Bereiche außerhalb des ursprünglichen Prüfumfangs werden nicht automatisch geprüft. Auch die Aussage „nicht mehr reproduzierbar“ und der Nachweis „Fehlerklasse systematisch beseitigt“ sind nicht immer identisch. Der Bericht sollte deshalb klar benennen, welche Version, welche Endpunkte und welche Varianten Gegenstand der Nachprüfung waren.
Im Auftrag sollte deshalb klar stehen, was „Retest bestanden“ bedeutet: Der vereinbarte Befund ist in der genannten Version nicht mehr reproduzierbar. Eine Aussage über neue Funktionen oder einen geänderten Prüfumfang folgt daraus nicht.
Ein guter Bericht erleichtert die Ursachenbehebung
Der Pentester muss nicht den fertigen Patch entwickeln. Ein verwertbarer Bericht sollte dem Team aber mehr liefern als einen Schwachstellennamen und einen CVSS-Wert:
- betroffene Rollen und notwendige Voraussetzungen,
- reproduzierbare Requests und relevante Responses,
- technische und geschäftliche Auswirkung,
- Hinweise auf betroffene Komponenten oder verwandte Zugriffspfade,
- eine realistische Korrekturrichtung,
- klare Aussagen zu Prüfumfang und Testgrenzen.
Das Entwicklungsteam kennt Wiederverwendungen und betriebliche Abhängigkeiten, die im Pentest nicht vollständig sichtbar werden. Ein kurzer Austausch spart hier oft Schleifen: Der Pentester beschreibt Angriffsweg und Varianten; das Team zeigt, wo die Autorisierungsregel technisch verankert ist.
Wie Ziele, Rollen und erlaubte Prüfhandlungen bereits vor dem Test festgelegt werden, beschreibe ich im Beitrag „Wie wird der Scope eines Web- und API-Pentests festgelegt?“.
Wann kann das Ticket wirklich geschlossen werden?
Die technische Ursache muss angemessen adressiert, die Korrektur in der vorgesehenen Umgebung ausgerollt und der relevante Angriffspfad erneut geprüft sein. Bei systematischen Fehlern gehören verwandte Pfade und Regressionstests dazu.
Die Zahl geschlossener Befunde ist eine Projektkennzahl. Ob ein Angriffsweg tatsächlich verschwunden ist, bleibt eine technische Frage. Beides sollte nicht miteinander verwechselt werden.