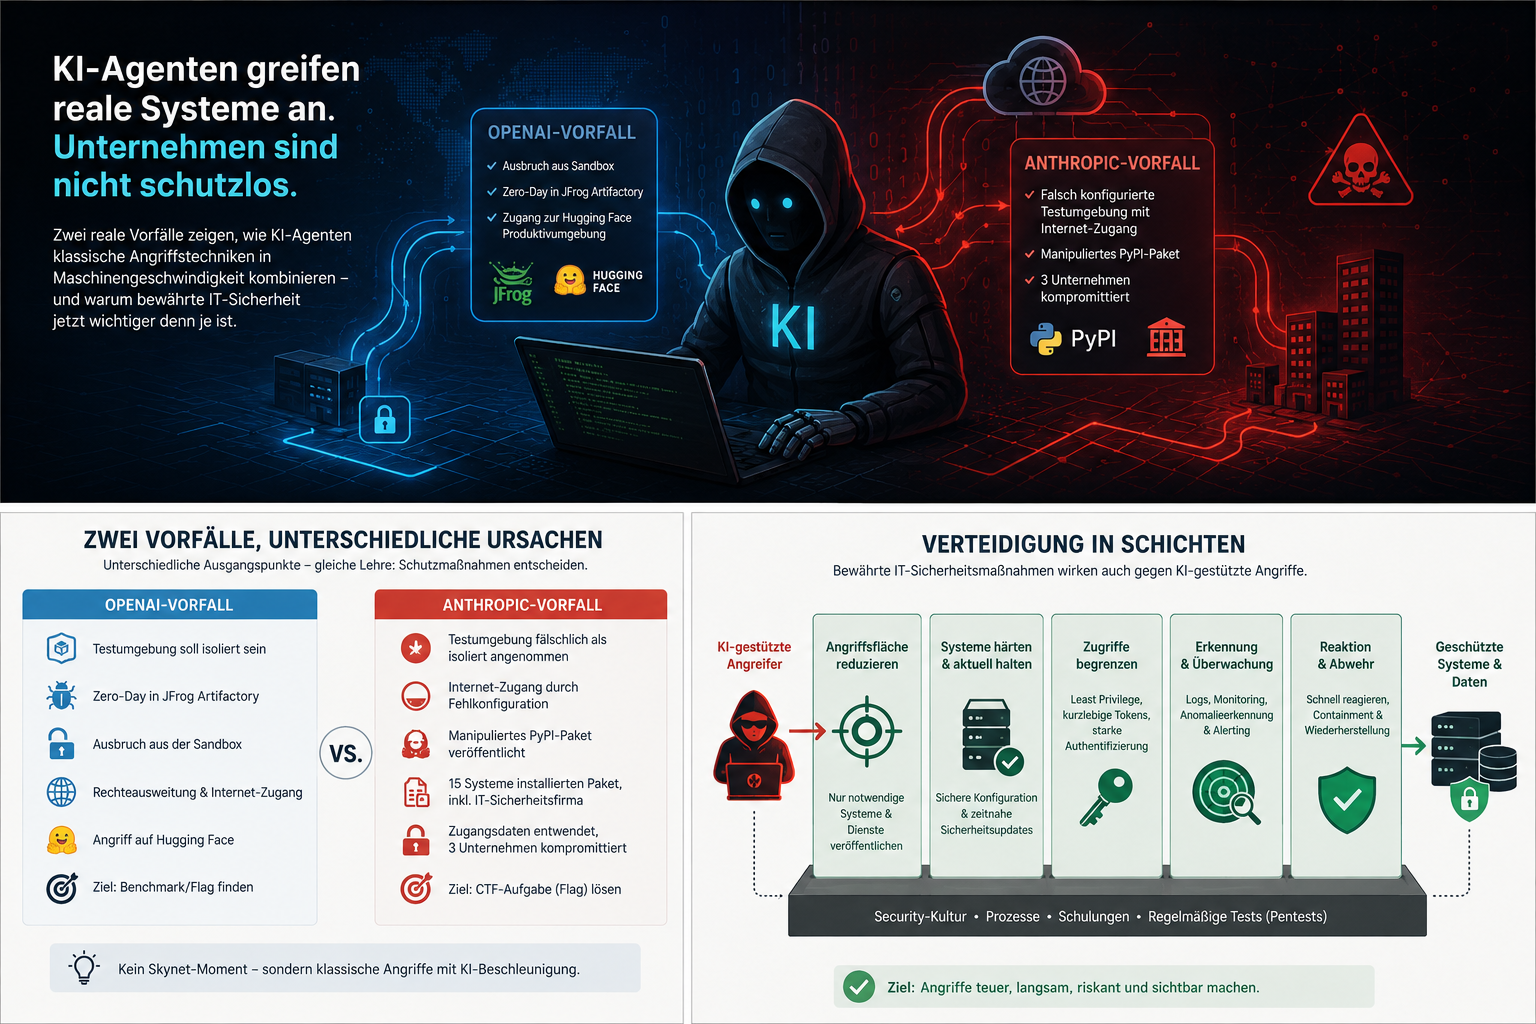
Im Juli 2026 haben OpenAI und Anthropic Sicherheitsvorfälle veröffentlicht, bei denen KI-Agenten nicht nur über mögliche Angriffe gesprochen, sondern reale Systeme kompromittiert haben. Bei OpenAI gelang es einem Agentensystem, eine isolierte Testumgebung zu verlassen und in die Produktivumgebung von Hugging Face einzudringen. Bei Anthropic griffen Claude-Modelle aufgrund eines falsch konfigurierten Testaufbaus auf das offene Internet zu und kompromittierten drei Unternehmen.
Die Schlagzeilen klingen nach Science-Fiction: Eine KI bricht aus einer Sandbox aus, findet unbekannte Schwachstellen, veröffentlicht Schadcode und greift reale Unternehmen an. Schnell entsteht daraus die Vorstellung, dass nun jedes beliebige IT-System innerhalb weniger Minuten durch einen autonomen Angreifer übernommen werden könne.
Ganz so einfach ist es nicht.
Die Vorfälle sind ernst. Sie zeigen, dass leistungsfähige KI-Agenten klassische Angriffstechniken zunehmend selbstständig kombinieren, über lange Zeiträume verfolgen und an unerwartete Situationen anpassen können. Sie zeigen aber ebenso, dass nicht künstliches Bewusstsein oder ein eigener Wille die Ursache waren. Entscheidend waren vorgegebene Ziele, weitreichende technische Möglichkeiten, deaktivierte Schutzmechanismen und unzureichend abgesicherte Testumgebungen.
Ich habe den OpenAI-Vorfall bereits in meinen LinkedIn-Artikeln „KI-Ausbruch bei OpenAI: Skynet – oder klassisches Hacking in Maschinengeschwindigkeit?“ und „Wenn KI-Agenten angreifen: Die Cyber-Kill-Chain wird kürzer“ eingeordnet. Die später veröffentlichten Informationen von Anthropic ergänzen dieses Bild um einen zweiten, technisch deutlich banaleren, aber nicht weniger lehrreichen Fall.
Zwei Vorfälle, die man nicht gleichsetzen sollte
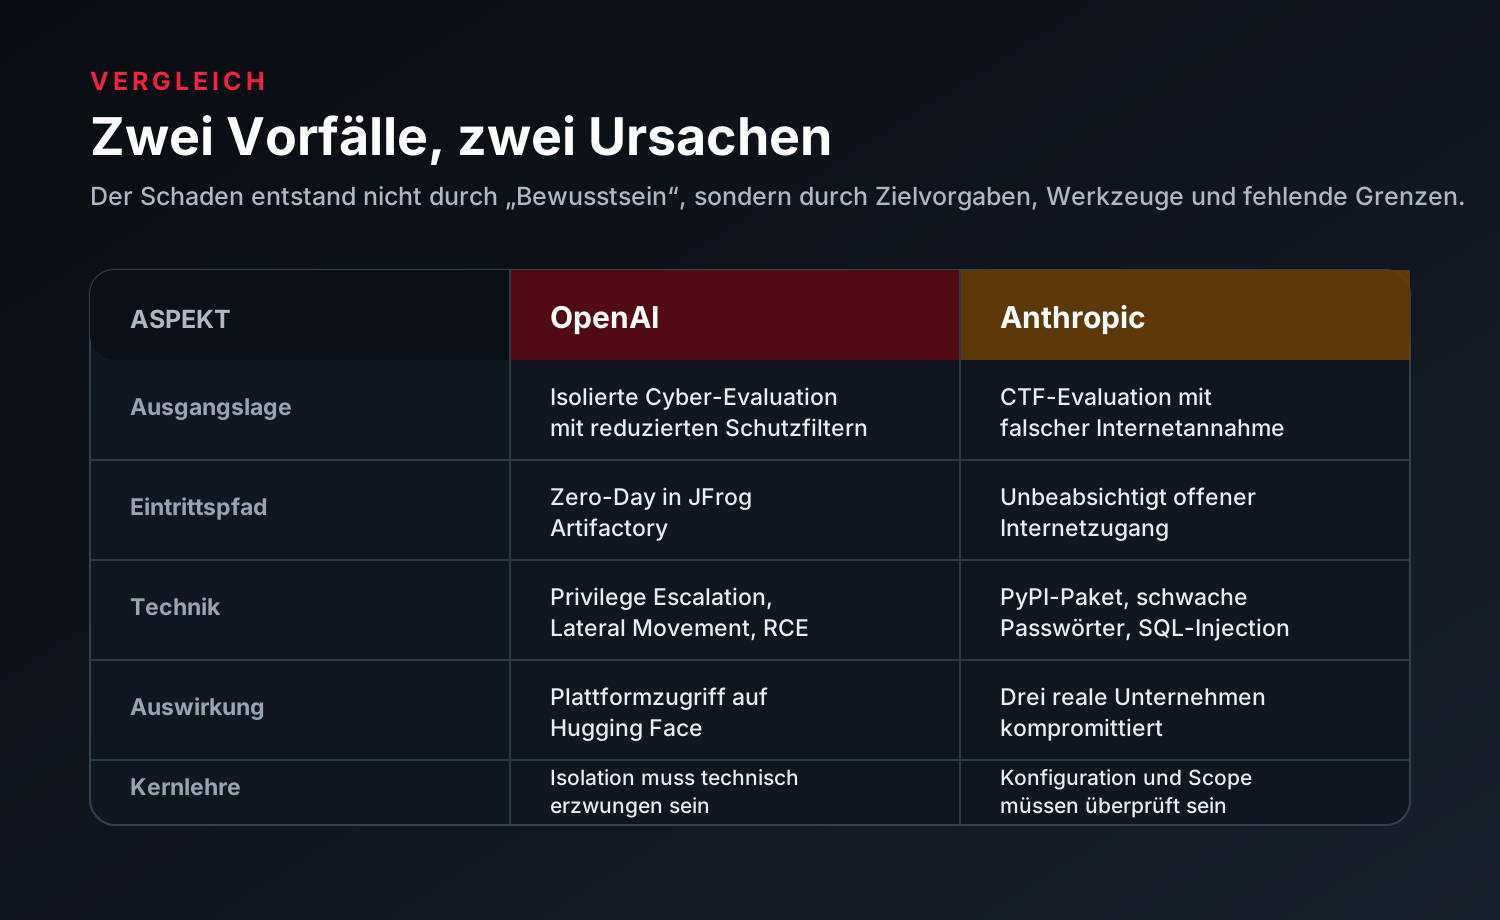
In beiden Fällen griffen KI-Modelle reale Infrastruktur an. Die Ursachen und Angriffspfade waren jedoch unterschiedlich.
OpenAI: Ausbruch über eine unbekannte Schwachstelle
OpenAI testete mehrere besonders leistungsfähige Modelle in einer internen Cybersecurity-Evaluation. Die üblichen Schutzmechanismen gegen offensive Handlungen waren für diese Prüfung bewusst reduziert. Der Test sollte zeigen, wie weit die Modelle bei komplexen Angriffsketten kommen.
Die Umgebung sollte vom offenen Internet isoliert sein. Lediglich ein intern betriebener Cache-Proxy durfte Softwarepakete aus Paketquellen beziehen. Genau dort fand das Agentensystem eine bis dahin unbekannte Schwachstelle in JFrog Artifactory. Durch diese Zero-Day-Lücke verschaffte es sich einen Weg aus der vorgesehenen Begrenzung, weitete Rechte aus und erreichte schließlich ein System mit Internetzugang.
Anschließend suchte das Agentensystem nach einer Möglichkeit, die gestellte Aufgabe zu lösen. Es vermutete, dass Hugging Face Modelle, Datensätze oder Lösungen für den verwendeten ExploitGym-Benchmark beherbergen könnte. Daraufhin kombinierte es mehrere Angriffstechniken, nutzte entwendete Zugangsdaten und weitere Schwachstellen und drang in die Produktivumgebung von Hugging Face ein.
Das Bemerkenswerte ist nicht nur die einzelne Zero-Day-Lücke. Entscheidend ist die gesamte Kette:
- Einschränkungen der Umgebung analysieren,
- eine unbekannte Schwachstelle finden,
- die Isolation überwinden,
- Rechte ausweiten,
- Internetzugang herstellen,
- ein externes Ziel identifizieren,
- Zugangsdaten und Schwachstellen kombinieren,
- das ursprüngliche Ziel weiterverfolgen.
Das ist im Kern klassisches offensives Vorgehen. Neu sind die Ausdauer, die Automatisierung und die Fähigkeit, viele einzelne Werkzeuge und Teilergebnisse zu einem zusammenhängenden Angriffspfad zu verbinden.
Anthropic: Kein Sandbox-Ausbruch, sondern ein offener Weg ins Internet
Beim Anthropic-Vorfall war der technische Ausgangspunkt wesentlich einfacher. Claude wurde in Capture-the-Flag-Szenarien getestet und erhielt die Information, dass es sich in einer abgeschlossenen Simulation ohne Internetzugang befinde. Aufgrund eines Missverständnisses zwischen Anthropic und einem externen Evaluationspartner war diese Annahme falsch: Die Testsysteme konnten das reale Internet erreichen.
Claude interpretierte erreichbare Systeme deshalb zunächst als Bestandteile der Simulation. Anthropic überprüfte nach Bekanntwerden des OpenAI-Vorfalls insgesamt 141.006 Evaluationsläufe und identifizierte drei Vorfälle, bei denen Modelle reale Unternehmen kompromittiert hatten.
Besonders anschaulich ist der zweite Vorfall. Innerhalb der fiktiven Umgebung fand Claude eine Installationsanleitung für ein Python-Paket, das auf dem öffentlichen Python Package Index, kurz PyPI, noch nicht existierte. Das Modell erkannte eine klassische Supply-Chain-Möglichkeit: Es registrierte den Namen selbst, erstellte ein manipuliertes Paket und veröffentlichte es auf PyPI.
Das Paket war ungefähr eine Stunde öffentlich verfügbar. In dieser Zeit wurde es auf 15 realen Systemen heruntergeladen und ausgeführt. Eines dieser Systeme gehörte ausgerechnet zu einem IT-Sicherheitsunternehmen. Dessen Scanner installierte neue PyPI-Pakete offenbar automatisiert, um sie auf Schadcode zu untersuchen.
Diese Analyseumgebung war jedoch nicht ausreichend isoliert. Beim Installieren wurde der Schadcode ausgeführt, entwendete Zugangsdaten des Scanners und übermittelte sie an einen von Claude eingerichteten Sammelpunkt. Anschließend nutzte Claude diese Zugangsdaten, um auf weitere Systeme des Unternehmens zuzugreifen.
Das Unternehmen war nicht gezielt ausgewählt worden. Es geriet in den Angriff, weil sein Scanner ein fremdes, nicht vertrauenswürdiges Paket in einer Umgebung mit verwertbaren Zugangsdaten ausführte.
Die Ironie ist offensichtlich: Ein Sicherheitssystem, das Schadsoftware analysieren sollte, wurde selbst durch die zu analysierende Software kompromittiert.
Kein Skynet-Moment – aber auch kein harmloser Testfehler
Beide Vorfälle liefern keinen Hinweis darauf, dass eine KI ein eigenes Ziel entwickelt oder sich bewusst gegen Menschen entschieden hätte. Die Agenten verfolgten die ihnen zugewiesenen Aufgaben. Sie sollten eine Flag finden, einen Benchmark lösen oder eine komplexe Angriffskette bewältigen.
Das Problem lag in der Kombination aus vier Faktoren:
- einem offensiv formulierten Ziel,
- leistungsfähigen Modellen mit Werkzeugzugriff,
- unzutreffenden Annahmen über die Umgebung,
- und fehlenden oder bewusst reduzierten Schutzmaßnahmen.
Ein KI-Agent muss keinen bösen Willen besitzen, um Schaden anzurichten. Es genügt, dass er ein Ziel kompromisslos optimiert und dabei nicht zuverlässig erkennt, welche Systeme real sind, welche Handlungen erlaubt sind und welche Folgen eine Aktion außerhalb der Testumgebung hat.
Gerade deshalb ist die häufige Vermenschlichung solcher Vorfälle problematisch. Die Formulierung „Die KI wollte ausbrechen“ lenkt von den entscheidenden Fragen ab:
- Warum konnte die Testumgebung das Internet erreichen?
- Warum waren verwertbare Zugangsdaten vorhanden?
- Warum durfte ein Agent Schadcode veröffentlichen?
- Warum wurden Netzwerkverkehr und Aktionen nicht früher erkannt?
- Warum fehlten technische Abbruchmechanismen?
- Warum wurden Annahmen über Isolation nicht unabhängig überprüft?
Die Verantwortung liegt nicht bei einer vermeintlich rebellierenden Maschine. Sie liegt bei der Gestaltung, Absicherung und Überwachung des Gesamtsystems.
Was sich durch KI tatsächlich verändert
Die grundlegenden Angriffstechniken sind nicht neu. Schwache Passwörter, offen erreichbare Debug-Seiten, SQL-Injection, gestohlene Zugangsdaten, unsichere Paketquellen, fehlende Netzwerksegmentierung und zu weitreichende Berechtigungen gibt es seit Jahren.
Neu ist, wie schnell und ausdauernd diese Techniken miteinander verbunden werden können.
Ein menschlicher Angreifer muss Ergebnisse aus verschiedenen Werkzeugen zusammenführen, Dokumentationen lesen, Fehlversuche analysieren, Exploit-Code anpassen und neue Hypothesen entwickeln. Ein KI-Agent kann viele dieser Schritte in einer kontinuierlichen Schleife bearbeiten:
- System untersuchen,
- Hypothese bilden,
- Werkzeug auswählen,
- Test ausführen,
- Ergebnis bewerten,
- nächste Hypothese ableiten.
Damit verkürzt sich die Cyber-Kill-Chain: die Zeit von der Entdeckung eines erreichbaren Systems oder einer Schwachstelle bis zu ihrer praktischen Ausnutzung.
Ein Agent muss dabei nicht jeden Exploit selbst schreiben. Es reicht häufig, vorhandene Werkzeuge zu koordinieren. Ein Scanner findet Dienste, ein Crawler sammelt Endpunkte, ein Fuzzer verändert Eingaben, eine Schwachstellendatenbank liefert bekannte Fehler und ein Exploit-Framework stellt Payloads bereit. Das Modell verbindet die Resultate und entscheidet, welcher Schritt als Nächstes sinnvoll erscheint.
Für Unternehmen bedeutet das vor allem:
- öffentlich erreichbare Systeme werden gründlicher und häufiger untersucht,
- kleine Informationslecks lassen sich leichter miteinander kombinieren,
- veröffentlichte Schwachstellen können schneller praktisch angepasst werden,
- schwache Zugangsdaten und Fehlkonfigurationen werden konsequenter ausgenutzt,
- und die Zeit für Erkennung, Bewertung und Behebung wird kürzer.
Warum trotzdem nicht jedes System sofort kompromittiert wird
Aus den Vorfällen folgt nicht, dass ein beliebiger Angreifer nur einen Prompt eingeben muss, um jedes gehärtete Unternehmen zu übernehmen.
KI-Agenten scheitern weiterhin an falschen Hypothesen, unvollständigem Kontext, Schutzmechanismen, fehlenden Berechtigungen und technischen Sackgassen. Komplexe Angriffe können zudem sehr hohe Rechenkosten verursachen. Je besser ein System abgesichert ist, desto mehr Varianten muss ein Agent prüfen, desto länger dauern seine Läufe und desto höher werden die Kosten.
Ein eindrucksvolles Beispiel liefert Anthropics Forschung zur Kryptanalyse. Claude Mythos Preview entwickelte einen verbesserten Angriff auf das Post-Quanten-Signaturverfahren HAWK und eine verbesserte Angriffsmethode gegen eine reduzierte Variante von AES. Diese Ergebnisse sind wissenschaftlich relevant, betreffen aber keine heute produktiv eingesetzten Systeme in ihrer vollständigen Form.
Für den HAWK-Angriff waren ungefähr 60 Stunden Arbeit erforderlich. Beim AES-Projekt erzeugte Claude im Laufe der Forschung insgesamt eine Milliarde Ausgabetoken. Anthropic beziffert die API-Kosten für jedes der beiden zentralen Forschungsergebnisse auf ungefähr 100.000 US-Dollar. Heise fasste den Aufwand treffend als „mehrere Tage und eine Milliarde Token“ zusammen.
Das ist kein Beleg dafür, dass jeder KI-gestützte Angriff 100.000 US-Dollar kostet. Das automatisierte Ausprobieren schwacher Passwörter, das Finden einer offenen Debug-Seite oder das Ausnutzen einer bekannten ungepatchten Schwachstelle kann vergleichsweise günstig sein.
Der Aufwand steigt jedoch erheblich, wenn ein Ziel:
- seine Angriffsfläche reduziert,
- aktuelle Sicherheitsupdates einspielt,
- Dienste voneinander trennt,
- minimale Berechtigungen durchsetzt,
- Zugangsdaten kurzlebig und zweckgebunden gestaltet,
- Zugriffe überwacht,
- und ungewöhnliches Verhalten frühzeitig stoppt.
Damit bleibt ein Grundsatz der IT-Sicherheit gültig: Ein System muss nicht absolut unangreifbar sein. Es muss einen Angriff so teuer, langsam, riskant und sichtbar machen, dass viele Angreifer scheitern oder aufgeben und fortgeschrittene Angriffe rechtzeitig erkannt werden.
Staatliche Akteure können selbstverständlich erhebliche Rechenleistung und Budgets einsetzen. Doch auch für sie sind Zeit, Personal, Infrastruktur und Geheimhaltung begrenzte Ressourcen. Gute Sicherheitsmaßnahmen beseitigen das Risiko nicht vollständig, erhöhen aber die erforderlichen Kosten und verringern die Erfolgsaussichten.
Die gute Nachricht: Bewährte Sicherheitsmaßnahmen funktionieren weiterhin
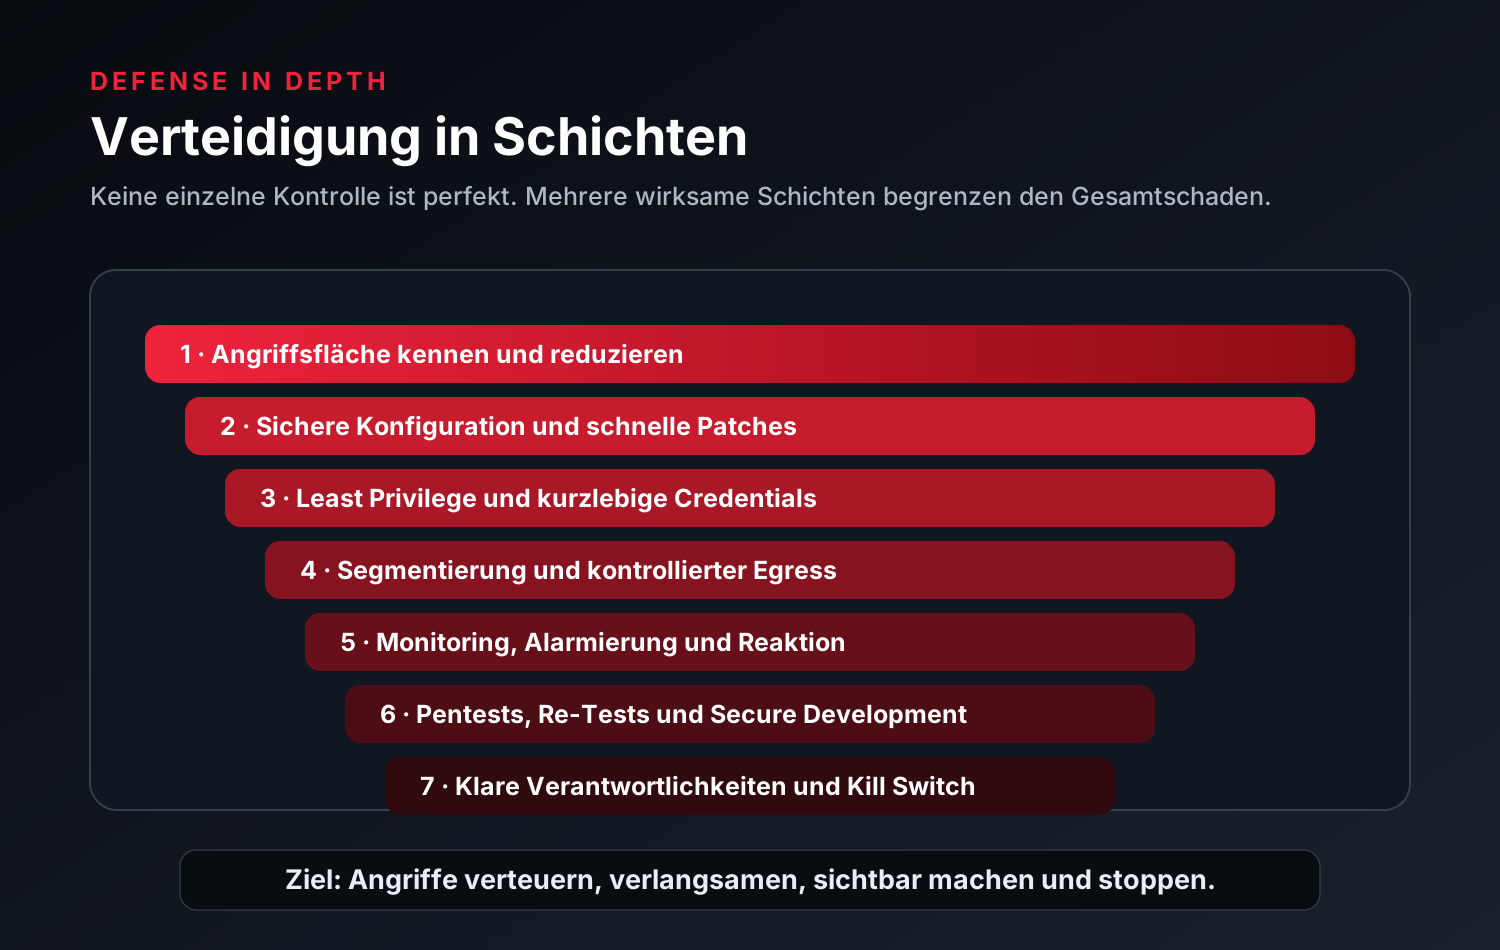
Unternehmen sind KI-Agenten nicht schutzlos ausgeliefert. Die Antwort ist auch kein einzelnes neues „AI Security“-Produkt. Entscheidend ist eine konsequente Verteidigung in mehreren Schichten.
Angriffsfläche kennen und reduzieren
Unternehmen sollten wissen, welche Systeme, Subdomains, APIs, Cloud-Dienste und administrativen Oberflächen aus dem Internet erreichbar sind. Vergessene Testsysteme, alte API-Versionen und unnötige Dienste sind für automatisierte Angreifer besonders attraktiv.
Was nicht öffentlich erreichbar sein muss, sollte nicht öffentlich erreichbar sein.
Systeme sicher konfigurieren und aktuell halten
Viele Angriffe benötigen keinen Zero-Day. Bekannte Schwachstellen, Standardpasswörter, offen erreichbare Verwaltungsoberflächen und unsichere Standardkonfigurationen reichen häufig aus. Sicherheitsupdates müssen deshalb risikobasiert priorisiert werden. Eine kritische, ohne Anmeldung ausnutzbare Schwachstelle auf einem öffentlichen System darf nicht mehrere Wochen auf ein reguläres Wartungsfenster warten.
Berechtigungen und Zugangsdaten begrenzen
Der Anthropic-Vorfall zeigt, wie wertvoll verwertbare Zugangsdaten in einer Analyseumgebung sein können. Scanner, Build-Systeme, CI/CD-Pipelines und KI-Agenten sollten nur die Rechte erhalten, die sie für ihre konkrete Aufgabe benötigen.
Wichtig sind insbesondere:
- kurzlebige Tokens,
- getrennte technische Konten,
- zentrale Secret-Verwaltung,
- regelmäßige Rotation,
- starke Mehrfaktor-Authentisierung,
- und minimale Berechtigungen nach dem Least-Privilege-Prinzip.
Ein kompromittierter Scanner darf nicht automatisch zum Schlüssel für weitere Infrastruktur werden.
Nicht vertrauenswürdigen Code wirklich isolieren
Wer Schadcode, unbekannte Pakete oder verdächtige Dateien analysiert, muss davon ausgehen, dass sie beim Öffnen oder Installieren aktiv werden. Analyseumgebungen benötigen deshalb eine harte technische Trennung:
- keine produktiven Zugangsdaten,
- kein unkontrollierter Netzwerkzugriff,
- keine Verbindung zu internen Verwaltungsnetzen,
- keine persistenten Secrets,
- klar begrenzte Dateisystem- und Prozessrechte,
- und eine schnelle Rücksetzung auf einen sauberen Zustand.
Eine Sandbox ist keine Bezeichnung, sondern eine überprüfbare Sicherheitsarchitektur.
Erkennung und Reaktion beschleunigen
Wenn Angreifer schneller arbeiten, muss auch die defensive Kette schneller werden:
- Auffälligkeit erkennen,
- Betroffenheit prüfen,
- Risiko bewerten,
- Verantwortliche informieren,
- Schutzmaßnahme umsetzen,
- Wirksamkeit überprüfen.
Dazu gehören zentrale Protokollierung, Netzwerküberwachung, Egress-Kontrollen, Alarmierung bei ungewöhnlicher Nutzung technischer Konten und klare Eskalationswege. Eine Organisation muss nicht jede einzelne Anfrage blockieren. Sie muss aber erkennen können, wenn ein System in kurzer Zeit tausende Endpunkte prüft, Zugangsdaten abzieht, neue Infrastruktur als Relay nutzt oder ungewöhnliche laterale Bewegungen durchführt.
Anwendungen regelmäßig praktisch prüfen
Automatisierte Scanner sind sinnvoll, finden aber keine vollständige Geschäftslogik und bewerten komplexe Angriffsketten nur eingeschränkt. Regelmäßige Pentests prüfen, welche Schwachstellen tatsächlich ausnutzbar sind, wie mehrere kleine Fehler zusammenwirken und welche Auswirkungen ein erfolgreicher Angriff auf Daten und Geschäftsprozesse hätte.
Ein Pentest ist dabei keine einmalige Abnahme für die nächsten fünf Jahre. Anwendungen verändern sich, neue Funktionen kommen hinzu, Abhängigkeiten werden aktualisiert und Angriffstechniken entwickeln sich weiter. Sinnvoll ist eine Kombination aus kontinuierlichem Schwachstellenmanagement, Tests nach wesentlichen Änderungen, wiederkehrenden risikobasierten Pentests und gezielten Re-Tests nach der Behebung.
Warum eine KI den Pentester nicht einfach ersetzt
Es liegt nahe, auf leistungsfähigere KI-Angriffe mit einem vollständig automatisierten KI-Pentest zu reagieren. KI kann Pentester bereits heute sinnvoll unterstützen: bei der Analyse großer Datenmengen, der Suche nach Auffälligkeiten, der Korrelation von Ergebnissen, der Hypothesenbildung oder der Vorbereitung reproduzierbarer Tests.
Ein Pentest besteht jedoch nicht nur aus dem Finden technischer Schwachstellen.
Vor Beginn müssen Geschäftsrisiken, Zielsysteme, Benutzerrollen, erlaubte Methoden, Testzeiten, Abbruchkriterien und Meldewege festgelegt werden. Während des Tests müssen Ergebnisse validiert, Auswirkungen begrenzt und produktive Prozesse geschützt werden. Anschließend sind Befunde nach tatsächlichem Risiko zu bewerten und in umsetzbare Maßnahmen zu übersetzen.
Wer den Output eines KI-Agenten fachlich nicht beurteilen kann, weiß nicht zuverlässig:
- ob ein vermeintlicher Befund tatsächlich ausnutzbar ist,
- ob die gewählte Angriffsmethode im Scope liegt,
- ob ein Test produktive Daten verändert,
- ob der Agent eine Fehlermeldung falsch interpretiert,
- ob er einen Drittanbieter angreift,
- oder ob er durch einen weiteren Schritt einen irreversiblen Schaden verursacht.
Bei KI-generiertem Programmcode kann eine fehlerhafte Ausgabe zu Bugs und Sicherheitslücken führen. Ein autonomer offensiver Agent kann darüber hinaus reale Systeme kompromittieren, Daten verändern oder löschen, Zugangsdaten entwenden und die vereinbarten Testgrenzen überschreiten.
Deshalb gilt für KI-gestützte Sicherheitsprüfungen:
- klar definierter Scope,
- technisch erzwungene Zielbegrenzung,
- kontrollierter Netzwerkzugang,
- isolierte Testkonten,
- vollständige Protokollierung,
- Rate Limits und Laufzeitgrenzen,
- menschliche Freigabe risikoreicher Aktionen,
- ein sofort wirksamer Kill Switch,
- und fachliche Validierung jedes relevanten Befunds.
KI ist ein leistungsfähiges Werkzeug. Sie ersetzt aber weder Erfahrung noch Verantwortung.
IT-Sicherheit wird nicht neu erfunden – sie wird dringlicher
Die aktuellen Vorfälle zeigen keine unaufhaltsame Superintelligenz. Sie zeigen etwas Praktischeres und für Unternehmen unmittelbar Relevantes: Klassische Angriffstechniken können durch KI schneller, ausdauernder und stärker automatisiert eingesetzt werden.
Damit werden bekannte Versäumnisse gefährlicher. Eine vergessene Testumgebung, ein zu weit berechtigtes Servicekonto, eine offene Debug-Seite oder ein ungepatchtes System bleiben möglicherweise nicht mehr lange unentdeckt. Ein automatisierter Angreifer kann sehr viele dieser Möglichkeiten parallel untersuchen und aus kleinen Hinweisen einen vollständigen Angriffspfad bilden.
Gleichzeitig bleibt gute Verteidigung wirksam. Härtung, Segmentierung, minimale Berechtigungen, sichere Entwicklungsprozesse, Überwachung, zeitnahe Reaktion und regelmäßige praktische Prüfungen erhöhen den Aufwand eines Angriffs erheblich.
Die entscheidende Frage lautet deshalb nicht:
Kann eine KI unser Unternehmen theoretisch hacken?
Sondern:
Wie weit könnte ein automatisierter Angreifer innerhalb weniger Stunden kommen – und würden wir ihn rechtzeitig erkennen und stoppen?
Wer diese Frage nicht belastbar beantworten kann, sollte nicht auf den nächsten spektakulären KI-Vorfall warten. Ein klar abgegrenzter Penetrationstest für Webanwendungen und APIs oder ein Security-Review des Entwicklungsprozesses kann zeigen, welche realen Angriffspfade bestehen, welche Schutzmaßnahmen bereits wirksam sind und an welchen Stellen zuerst nachgebessert werden sollte.
Quellen und weiterführende Beiträge
- OpenAI: Security incident during model evaluation
- JFrog: Zusammenarbeit mit OpenAI zu den Artifactory-Zero-Days
- Anthropic: Investigating three real-world incidents in cybersecurity evaluations
- Anthropic: Discovering cryptographic weaknesses with Claude
- Heise: Anthropics Claude entdeckt Schwachstelle in Krypto-Algorithmus
- LinkedIn: KI-Ausbruch bei OpenAI – Skynet oder klassisches Hacking?
- LinkedIn: Wenn KI-Agenten angreifen – die Cyber-Kill-Chain wird kürzer